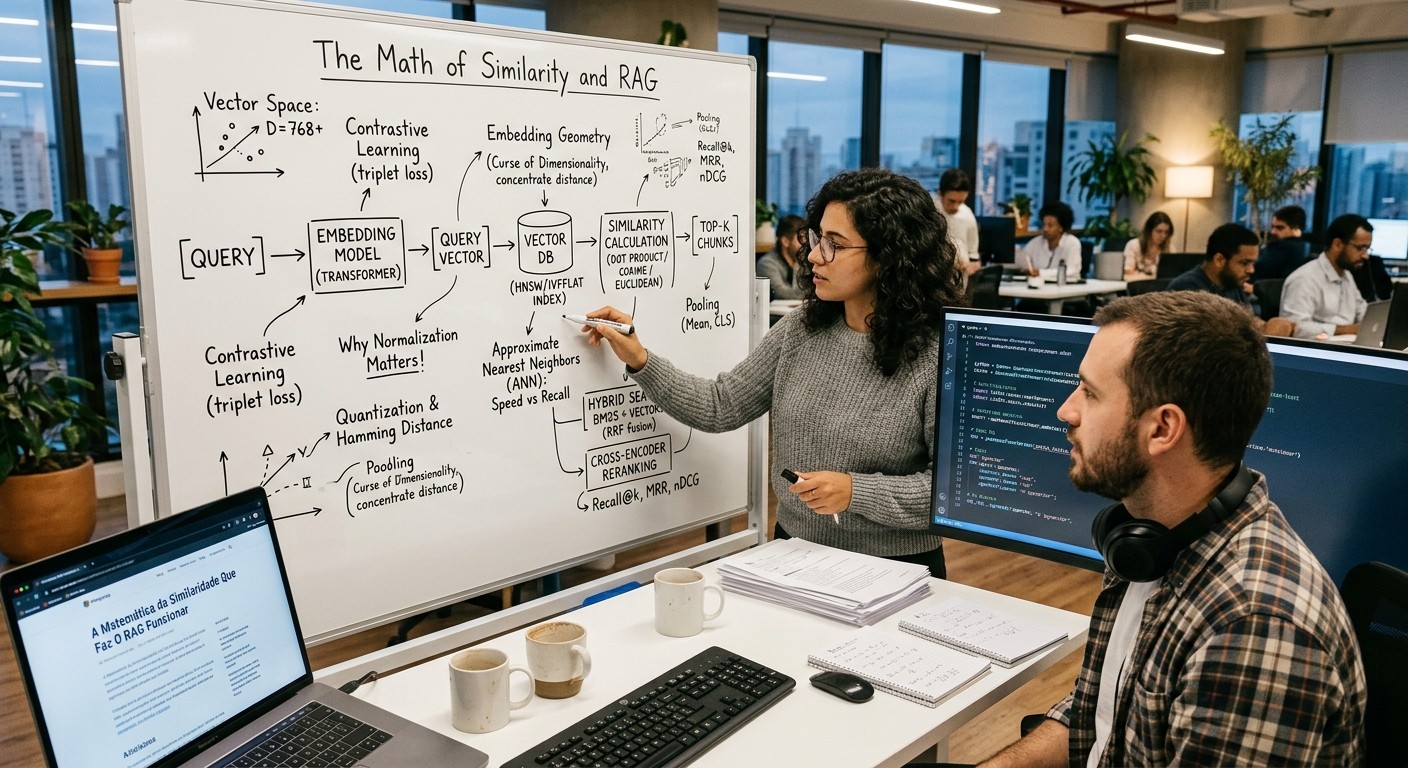
Do treino do modelo de embedding ao grafo do índice vetorial, a busca do RAG é uma sequência de decisões matemáticas, e cada uma delas pode fazer o contexto certo sumir antes de chegar ao LLM.
Olá, meus caros leitores, já tem alguns meses que ando estudando a fundo os conceitos de aplicações de Engenharia de Inteligência Artificial. Resolvi não desenvolver um artigo explicando o que é RAG (já existem muitos por aí, inclusive no Blog), mas sim como a matemática é aplicada diretamente em cada etapa da busca: na forma como o texto vira vetor, na régua que compara esses vetores, no índice que evita comparar com todo mundo e nas camadas que corrigem os erros dessa régua.
O LLM não procura nada. Quem procura é uma cadeia de contas. O RAG só é tão bom quanto o trecho que chega ao prompt, e esse trecho é escolhido por geometria, estatística e estruturas de dados, não por inteligência. Quando a resposta sai errada, a culpa costuma estar em algum elo dessa cadeia, muito antes do modelo de linguagem.
Vou percorrer a cadeia na ordem em que ela acontece. Onde houver número, ele foi calculado e o código está no texto para quem quiser reproduzir.
Do texto ao vetor
Um modelo de embedding é, na maioria dos casos, um transformer do tipo encoder. O texto é quebrado em tokens, cada token vira um vetor inicial, e as camadas de atenção vão reescrevendo esses vetores para que cada um carregue informação do contexto ao redor. No fim, sai um vetor por token, e não um vetor para o texto.
Para chegar a um vetor único, entra o pooling. As duas formas mais comuns são pegar o vetor de um token especial que o modelo aprendeu a usar como resumo (o famoso [CLS]) ou tirar a média de todos os vetores de token:
e(texto) = (h1 + h2 + ... + hn) / n
Guarde essa média, ela volta mais adiante para explicar por que trechos grandes demais estragam a busca. Depois do pooling, muitos modelos ainda normalizam o vetor, dividindo cada coordenada pela norma |e| = √(e1² + e2² + ... + ed²), para que todos os vetores tenham tamanho 1. O resultado é um ponto na superfície de uma hiperesfera de centenas ou milhares de dimensões. É nessa superfície que a busca acontece.
Como o modelo aprende o que é "parecido"
Um transformer recém-treinado para prever palavras não gera bons vetores de busca. O que transforma o encoder num modelo de embedding é um segundo treino, o aprendizado contrastivo. A ideia é alimentar o modelo com pares que deveriam ficar próximos (uma pergunta e o trecho que a responde) e empurrar todo o resto para longe.
A função de perda mais usada nesse tipo de treino é a InfoNCE. Para uma pergunta q, o trecho correto d+ e os demais trechos do lote dj:
L = −log( exp(sim(q, d+) / τ) / Σj exp(sim(q, dj) / τ) )
Quem já viu classificação reconhece o formato: é uma softmax seguida de entropia cruzada. O modelo é tratado como se estivesse escolhendo, entre todos os trechos do lote, qual é o par certo da pergunta. Os outros pares do mesmo lote servem de exemplos negativos de graça, o que se chama de in-batch negatives. O τ é a temperatura. Valores pequenos amplificam as diferenças de similaridade dentro da exponencial e obrigam o modelo a separar com mais força o certo do quase certo.
A consequência prática está no sim() dessa fórmula. O modelo aprende a organizar o espaço para uma métrica específica, a que foi usada no treino. Na maioria dos modelos de busca ela é o cosseno, ou o produto escalar entre vetores normalizados, que é a mesma coisa. Comparar os vetores com outra régua é medir com uma escala para a qual o modelo nunca foi ajustado. É por isso que a documentação dos modelos diz qual métrica usar, e vale levar isso a sério.
As três réguas e por que elas discordam
Para enxergar as diferenças, um exemplo em três dimensões. As dimensões são inventadas, como se medissem o quanto um texto fala de pagamento, entrega e conta do cliente. Um modelo real não tem eixos legíveis assim, mas as contas são as mesmas. A pergunta é "como pago com Pix?":
- Pergunta (q):
[0.9, 0.1, 0.3] - Trecho A, formas de pagamento:
[0.8, 0.2, 0.4] - Trecho B, prazo de entrega:
[0.5, 0.7, 0.2] - Trecho C, FAQ geral, com valores grandes de propósito:
[2.0, 1.8, 1.0]
As três réguas:
- Produto escalar:
a · b = Σ ai × bi. Maior é melhor. Mistura direção e tamanho. - Cosseno:
cos(θ) = (a · b) / (|a| × |b|). Maior é melhor. Só olha a direção. - Distância euclidiana:
|a − b| = √Σ (ai − bi)². Menor é melhor. Mede a linha reta entre os pontos.
| Trecho | Produto escalar | Cosseno (ângulo) | Euclidiana bruta | Euclidiana normalizada |
|---|---|---|---|---|
| A (pagamento) | 0.86 (2º) | 0.984, 10° (1º) | 0.173 (1º) | 0.181 (1º) |
| B (entrega) | 0.58 (3º) | 0.688, 46° (3º) | 0.728 (2º) | 0.789 (3º) |
| C (FAQ geral) | 2.28 (1º) | 0.833, 34° (2º) | 2.142 (3º) | 0.579 (2º) |
Com vetores de tamanhos diferentes, cada régua elegeu uma ordem. O produto escalar pôs a FAQ genérica em primeiro, porque premia o vetor "grande". A distância euclidiana pôs a mesma FAQ em último, porque o ponto dela fica longe de todo mundo. Só o cosseno acertou a ordem que a intuição pede.
Agora a parte que amarra tudo. Se os vetores forem normalizados, vale esta identidade, que sai direto de expandir o quadrado da distância:
|a − b|² = |a|² + |b|² − 2(a · b) = 1 + 1 − 2 cos(θ) = 2 − 2 cos(θ)
Com vetores unitários, as três réguas viram a mesma régua em escalas diferentes. O produto escalar é o cosseno, e a distância é uma função decrescente do cosseno. A última coluna da tabela confirma: a ordem é idêntica à do cosseno. Isso tem uma consequência de engenharia. Com vetores normalizados, dá para usar o produto escalar, que é a conta mais barata (não precisa calcular normas), e ter exatamente o ranking do cosseno.
import numpy as np

q = np.array([0.9, 0.1, 0.3])
trechos = {
    "A (pagamento)": np.array([0.8, 0.2, 0.4]),
    "B (entrega)":   np.array([0.5, 0.7, 0.2]),
    "C (FAQ geral)": np.array([2.0, 1.8, 1.0]),
}

def cosseno(a, b):
    return a @ b / (np.linalg.norm(a) * np.linalg.norm(b))

def normalizar(v):
    return v / np.linalg.norm(v)

for nome, t in trechos.items():
    print(
        f"{nome:14} "
        f"dot={q @ t:.2f}  "
        f"cos={cosseno(q, t):.3f}  "
        f"L2={np.linalg.norm(q - t):.3f}  "
        f"L2_norm={np.linalg.norm(normalizar(q) - normalizar(t)):.3f}"
    )
O espaço de alta dimensão não se comporta como o 3D
O exemplo acima ajuda a entender as fórmulas, mas engana sobre a escala. Em 768 ou 1536 dimensões, a geometria tem propriedades que não aparecem em três, e elas explicam vários comportamentos estranhos da busca.
Quase tudo é perpendicular a quase tudo
Se você sortear dois vetores unitários em direções aleatórias, o cosseno entre eles tem média zero e desvio padrão de aproximadamente 1/√d, onde d é o número de dimensões. Em 3D, isso é 0.58: qualquer valor de cosseno é comum. Em 768 dimensões, cai para 0.036. Rodei uma simulação com 20 mil pares aleatórios para cada caso:
| Dimensões | Desvio do cosseno (medido) | 1/√d (teórico) | Pares com |cos| acima de 0.1 |
|---|---|---|---|
| 3 | 0.578 | 0.577 | 90% |
| 768 | 0.036 | 0.036 | 0.5% |
| 1536 | 0.026 | 0.026 | praticamente 0% |
Em espaço de alta dimensão, direções sem relação são quase perpendiculares. Isso é ótimo para a busca: há "espaço" de sobra para acomodar milhões de significados diferentes sem que eles se esbarrem. Um cosseno que pareceria baixo em 3D, como 0.3, é um sinal fortíssimo de relação em 768 dimensões.
Mas os embeddings reais não se espalham pela esfera
Se os vetores de um modelo fossem aleatórios, textos sem relação dariam cosseno perto de zero. Na prática, não dão. Estudos sobre representações de modelos de linguagem observaram que elas costumam ser anisotrópicas: ocupam uma região estreita do espaço, como um cone, em vez de se espalharem por todas as direções. O efeito é que até dois textos sem nenhuma relação podem ter um cosseno bem acima de zero, e a faixa útil de notas fica comprimida.
É por isso que a nota de similaridade não é universal. Um cosseno de 0.80 pode ser uma correspondência excelente num modelo e um resultado medíocre em outro. Um limiar de corte ("só aceito trechos acima de 0.75") só faz sentido se for calibrado com perguntas reais e com o modelo que você usa. Copiar o limiar de um tutorial é copiar a escala de outra régua.
As distâncias se concentram
Um segundo efeito, conhecido como concentração de distâncias: à medida que a dimensão cresce, a distância do vizinho mais próximo e a do mais distante ficam relativamente parecidas. Na mesma simulação, sorteei 10 mil pontos aleatórios e uma consulta, e medi o contraste (distância máxima − distância mínima) / distância mínima:
- 3 dimensões: 64, ou seja, o ponto mais distante está dezenas de vezes mais longe que o mais próximo (em 3D esse valor oscila bastante a cada sorteio, porque depende de quão perto o ponto mais próximo caiu, mas fica sempre muito acima dos valores de alta dimensão)
- 768 dimensões: 0.20, o mais distante está só 20% mais longe
- 1536 dimensões: 0.13
Com dados aleatórios, "vizinho mais próximo" quase perde o sentido. Embeddings de texto não são aleatórios, eles têm estrutura, e é essa estrutura que salva a busca. Mas o efeito ajuda a entender duas coisas: por que pequenas diferenças de nota no topo do ranking são frágeis, e por que os índices aproximados, que veremos a seguir, conseguem errar um vizinho sem que ninguém perceba.
import numpy as np

rng = np.random.default_rng(42)

for d in [3, 768, 1536]:
    a = rng.standard_normal((20000, d))
    b = rng.standard_normal((20000, d))
    a /= np.linalg.norm(a, axis=1, keepdims=True)
    b /= np.linalg.norm(b, axis=1, keepdims=True)
    cos = (a * b).sum(axis=1)

    pontos = rng.standard_normal((10000, d))
    consulta = rng.standard_normal(d)
    dist = np.linalg.norm(pontos - consulta, axis=1)
    contraste = (dist.max() - dist.min()) / dist.min()

    print(f"d={d:5}  desvio_cos={cos.std():.3f}  1/sqrt(d)={1/np.sqrt(d):.3f}  "
          f"contraste={contraste:.2f}")
Achar o vizinho sem comparar com todo mundo
A busca exata é simples: calcular a similaridade da pergunta com cada um dos N vetores e ordenar. O custo é proporcional a N × d. Com um milhão de trechos em 1536 dimensões, são cerca de 1,5 bilhão de multiplicações por pergunta. Funciona em base pequena, mas não escala. Os índices vetoriais existem para fugir dessa conta, e todos fazem a mesma troca: abrem mão de garantir o vizinho exato em troca de velocidade. Por isso a busca se chama ANN, approximate nearest neighbor.
IVFFlat, dividir para não procurar em tudo
O IVFFlat roda um k-means sobre os vetores e divide o espaço em lists regiões, cada uma representada por um centroide. Na consulta, compara a pergunta só com os centroides, escolhe os probes mais próximos e faz busca exata apenas dentro dessas regiões.
O erro aparece na fronteira. Se o vizinho verdadeiro estiver numa região cujo centroide não ficou entre os probes escolhidos, ele simplesmente não é visto. Mais probes significa mais regiões vasculhadas, mais acerto e mais lentidão. No pgvector o padrão é 1 probe, o que é agressivo. Outro detalhe: os centroides são calculados na criação do índice, então criar o IVFFlat com a tabela vazia, ou antes de carregar a maior parte dos dados, produz regiões que não representam a base real.
HNSW, um grafo com atalhos
O HNSW (Hierarchical Navigable Small World) é hoje o índice mais usado, e a ideia dele é elegante. Cada vetor vira um nó num grafo, ligado a até M vizinhos próximos. Só que o grafo tem várias camadas. A camada 0 tem todos os nós. Cada camada acima tem uma fração cada vez menor, como uma lista de pulos (skip list) geométrica.
A camada máxima de cada nó é sorteada na inserção: l = ⌊−ln(U) × mL⌋, com U uniforme entre 0 e 1 e mL = 1/ln(M). Com essa escolha, a chance de um nó chegar à camada l é M^(−l). Com M = 16 (o padrão do pgvector) e um milhão de vetores, a distribuição esperada fica assim:
| Camada | Nós esperados |
|---|---|
| 0 | 1.000.000 |
| 1 | 62.500 |
| 2 | cerca de 3.900 |
| 3 | cerca de 244 |
| 4 | cerca de 15 |
| 5 | cerca de 1 |
A busca entra pelo topo, onde há pouquíssimos nós e as ligações cobrem grandes distâncias. Em cada camada, ela anda de forma gulosa para o vizinho mais próximo da pergunta, até não conseguir mais melhorar, e então desce uma camada, partindo do ponto onde parou. É como chegar a um endereço indo de rodovia para avenida e de avenida para rua. Na camada 0, em vez de seguir um único caminho, a busca mantém uma lista dos ef_search melhores candidatos encontrados até ali e vai expandindo os vizinhos deles.
É aí que mora o erro. A busca é gulosa: se o caminho ficar preso num mínimo local, o vizinho verdadeiro pode nunca ser visitado. Aumentar o ef_search alarga a lista de candidatos e reduz essa chance, com custo de latência. Na construção, o ef_construction faz o mesmo papel na hora de escolher as ligações de cada nó, e um grafo mal ligado não é consertado na consulta.
CREATE EXTENSION IF NOT EXISTS vector;

CREATE TABLE trechos (
    id        bigserial PRIMARY KEY,
    conteudo  text,
    embedding vector(1536)
);

-- HNSW: M ligações por nó, ef_construction candidatos na construção
CREATE INDEX ON trechos
USING hnsw (embedding vector_cosine_ops)
WITH (m = 16, ef_construction = 64);

-- Lista de candidatos na consulta (padrão 40)
SET hnsw.ef_search = 100;

SELECT id,
       conteudo,
       1 - (embedding <=> $1) AS similaridade
FROM trechos
ORDER BY embedding <=> $1
LIMIT 5;

-- Alternativa IVFFlat: criar depois de carregar os dados
-- CREATE INDEX ON trechos USING ivfflat (embedding vector_cosine_ops) WITH (lists = 1000);
-- SET ivfflat.probes = 30;
No pgvector, cada régua tem um operador e uma classe de índice, e as duas precisam casar. Um índice criado com vector_cosine_ops não é usado por uma consulta ordenada com <->. A query funciona, devolve resultado, só que varre a tabela inteira.
| Operador | O que calcula | Classe de operador |
|---|---|---|
<-> |
distância euclidiana | vector_l2_ops |
<#> |
produto escalar negativo (para caber no ORDER BY crescente) |
vector_ip_ops |
<=> |
distância de cosseno, 1 − cos(θ) |
vector_cosine_ops |
Comprimir vetores e o que se perde
Um vetor de 1536 dimensões em float32 ocupa 6.144 bytes. Um milhão deles, cerca de 6 GB, antes de contar o índice. Daí a quantização, que troca precisão numérica por memória:
| Representação | Bytes por vetor (1536 dim.) | 1 milhão de vetores |
|---|---|---|
float32 (vector) |
6.144 | cerca de 6,1 GB |
float16 (halfvec) |
3.072 | cerca de 3,1 GB |
1 bit por dimensão (bit) |
192 | cerca de 0,19 GB |
A quantização binária é a mais radical: cada coordenada vira 1 se for positiva e 0 se for negativa, e a comparação passa a ser a distância de Hamming, a contagem de bits diferentes. Parece perder informação demais, mas há uma base matemática por trás. Se os bits fossem obtidos com hiperplanos aleatórios (a técnica de LSH conhecida como SimHash), a probabilidade de um bit diferir entre dois vetores seria exatamente θ/π, o ângulo entre eles dividido por 180°. Ou seja, a contagem de bits diferentes estima o ângulo.
No nosso exemplo, o trecho A está a uns 10° da pergunta, então esperaríamos cerca de 6% de bits diferentes, contra uns 26% para o trecho B, que está a 46°. Usar o sinal das coordenadas originais não é a mesma coisa que hiperplanos aleatórios, então essa relação é uma aproximação, e a qualidade varia de modelo para modelo. O uso mais seguro é em duas etapas: a busca binária, barata, seleciona algumas dezenas de candidatos, e os vetores completos reordenam esses candidatos.
-- Índice sobre a versão binária do vetor
CREATE INDEX ON trechos
USING hnsw ((binary_quantize(embedding)::bit(1536)) bit_hamming_ops);

-- Etapa 1: Hamming seleciona candidatos; etapa 2: cosseno reordena
SELECT *
FROM (
    SELECT id, conteudo, embedding
    FROM trechos
    ORDER BY binary_quantize(embedding)::bit(1536) <~> binary_quantize($1)
    LIMIT 50
) candidatos
ORDER BY embedding <=> $1
LIMIT 5;
O tamanho do trecho também é matemática
Lembra do pooling por média? Ele explica um dos erros mais comuns de RAG. Imagine um trecho que fala de cinco assuntos sem relação, e simplifique cada assunto como um vetor unitário apontando para um eixo diferente. A média desses cinco vetores tem norma 1/√5 ≈ 0.45, e o cosseno dela com cada assunto também é 0.45. O vetor de um trecho que fala de tudo fica no meio de todos os assuntos e não aponta com força para nenhum.
O modelo real é mais sofisticado que uma média simples, porque a atenção pondera os tokens, mas a tendência continua. E o efeito é perverso: esse trecho genérico raramente fica longe de qualquer pergunta, então aparece no top-k o tempo todo, ocupando o lugar de trechos que realmente respondem. É o trecho C do nosso exemplo.
Esse ponto eu aprendi do jeito chato. Num projeto de estudo, montei um RAG em cima de um manual técnico em PDF e, para ganhar tempo, quebrei o documento por capítulo inteiro. Funcionou bem nos primeiros testes, até eu reparar que, para quase qualquer pergunta específica, o primeiro resultado era sempre o mesmo: a introdução do manual. Aquele capítulo que resume um pouco de tudo e não explica nada a fundo.
Passei um bom tempo desconfiando do modelo de embedding e da métrica, quando o problema estava antes disso. A introdução era o meu trecho C: um vetor que apontava "mais ou menos" para todos os assuntos e, por isso, ficava razoavelmente perto de qualquer pergunta. Bastou quebrar o manual por subseção, com uma pequena sobreposição entre os trechos, para o resultado certo voltar ao topo. Não mudei uma linha da busca.
Quando o vetor não basta, BM25 e fusão de rankings
Busca vetorial é boa com significado e ruim com literalidade. Um código de erro como ERR-4012, o número de um artigo de lei ou um nome de produto pouco comum podem cair em regiões do espaço que não têm nada a ver com o termo exato. A busca lexical clássica não tem esse problema, e a fórmula mais usada nela é a BM25:
BM25(D, Q) = Σt∈Q IDF(t) × f(t, D) × (k1 + 1) / ( f(t, D) + k1 × (1 − b + b × |D| / avgdl) )
f(t, D)é quantas vezes o termo aparece no documento. Ok1faz essa contagem saturar: repetir uma palavra 50 vezes não vale 50 vezes mais que repetir 5.|D| / avgdlcompara o tamanho do documento com a média da base, e obcontrola o quanto documentos longos são penalizados por terem mais chances de conter qualquer termo.IDF(t)dá mais peso a termos raros. Um termo que aparece em quase todos os documentos quase não pesa, e um código que aparece em um só pesa muito.
A busca híbrida roda as duas buscas e junta os resultados. O problema é que as notas não são comparáveis: um cosseno vai até 1, um BM25 não tem teto. Somar as duas é misturar unidades. A solução mais usada ignora as notas e olha só as posições, com a Reciprocal Rank Fusion (RRF):
RRF(d) = Σi 1 / (k + posiçãoi(d))
O k (60 é o valor mais citado) amortece a diferença entre as primeiras posições, para que um único ranking não domine o resultado. Um documento bem colocado nas duas listas tende a ganhar de um que só aparece no topo de uma:
def rrf(rankings, k=60):
    notas = {}
    for ranking in rankings:
        for posicao, doc in enumerate(ranking, start=1):
            notas[doc] = notas.get(doc, 0) + 1 / (k + posicao)
    return sorted(notas.items(), key=lambda x: x[1], reverse=True)

vetorial = ["A", "C", "B", "D"]
lexical  = ["D", "A", "E"]

for doc, nota in rrf([vetorial, lexical]):
    print(doc, round(nota, 5))

# A 0.03252   (1º na vetorial, 2º na lexical)
# D 0.03202   (4º na vetorial, 1º na lexical)
# C 0.01613
# B 0.01587
# E 0.01587
Repare no D: estava em quarto na busca vetorial, mas o primeiro lugar na lexical o trouxe para o segundo lugar geral. É exatamente o caso do código de erro que o vetor não reconheceu.
Reranking e o limite de comparar vetores separados
Existe um limite estrutural em tudo o que foi visto até aqui. O modelo de embedding é um bi-encoder: ele codifica a pergunta e o trecho separadamente, e a nota é uma conta entre dois vetores prontos, s(q, d) = e(q) · e(d). É isso que permite pré-calcular os vetores de toda a base, e é isso que torna a busca rápida.
O preço é que o trecho é resumido num vetor sem saber qual pergunta vai ser feita. Todo o significado precisa caber num ponto fixo do espaço. Um cross-encoder faz o contrário: recebe pergunta e trecho juntos, na mesma entrada, e a atenção cruza cada token da pergunta com cada token do trecho antes de produzir uma nota s = f(q, d). Essa função não se decompõe em dois vetores independentes, então capta nuances que o produto escalar não capta, como uma negação ou uma condição que muda o sentido da resposta.
O custo é que não dá para pré-calcular nada: cada par exige uma passada completa do modelo. Por isso a arquitetura comum é em funil. O bi-encoder, com o índice vetorial (e, de preferência, com a BM25 junto), traz algumas dezenas de candidatos em milissegundos, e o cross-encoder reordena só esses candidatos antes de entregar os melhores ao LLM.
Medindo se a busca está boa
Nenhum ajuste dos anteriores deveria ser feito no olho. Com um conjunto de perguntas reais e a indicação de quais trechos respondem cada uma, três métricas resolvem quase tudo:
- Recall@k: das respostas certas que existem, quantas apareceram entre os
kprimeiros. É a métrica mais importante para RAG, porque o que não entra no top-k nunca chega ao modelo. - MRR (Mean Reciprocal Rank): a média de
1 / posiçãodo primeiro trecho certo. Se em três perguntas o certo aparece em 1º, em 3º e nunca, o MRR é(1 + 1/3 + 0) / 3 ≈ 0.44. - nDCG@k: soma a relevância de cada resultado com um desconto logarítmico pela posição,
Σ reli / log2(i + 1), e divide pelo valor da ordem ideal. Serve quando há trechos mais e menos relevantes, e não só certo ou errado.
Com essas métricas, cada decisão do artigo vira um experimento: tamanho de chunk, ef_search, quantização, busca híbrida, reranking. Mede antes, muda uma coisa, mede depois. A comparação entre o índice aproximado e a busca exata, na mesma amostra, também diz quanto recall o índice está custando.
Checklist para quando o retrieval traz o trecho errado
- A métrica é a do treino do modelo? Confira na documentação se ele espera cosseno ou produto escalar.
- Os vetores estão normalizados? Calcule a norma de alguns. Se não der 1, produto escalar e distância euclidiana estão sendo influenciados pelo tamanho.
- Pergunta e base usam o mesmo modelo, na mesma versão? Mudou o modelo, reindexa tudo. Se o modelo diferencia entrada de consulta e de documento, use cada uma no lugar certo.
- O operador da query casa com a classe do índice? Rode
EXPLAINe confirme que o índice está sendo usado. - Quanto recall o índice aproximado está custando? Compare com a busca exata numa amostra e ajuste
ef_searchouprobes. - O IVFFlat foi criado depois dos dados? Centroides calculados sobre uma base vazia ou parcial produzem regiões ruins.
- O limiar de similaridade foi calibrado para este modelo? Ou foi herdado de um tutorial?
- Algum trecho genérico aparece em quase todas as buscas? É sinal de chunk grande demais, com vetor diluído.
- As perguntas com códigos, siglas e nomes próprios falham mais? Falta busca lexical. Considere BM25 com RRF.
- O trecho certo está no top-50 mas não no top-5? O problema é de ordenação, e um reranker resolve melhor que um modelo de embedding maior.
Pra fechar
A busca do RAG é uma cadeia: um modelo que aprendeu a organizar o espaço para uma régua específica, uma régua que pode discordar das outras quando os vetores não estão normalizados, um espaço de alta dimensão que comprime as notas, um índice que troca exatidão por velocidade, e um chunk que pode diluir o significado antes de tudo isso começar.
Cada elo tem uma conta por trás, e cada conta tem um jeito de falhar em silêncio. A query não dá erro, o índice não reclama, o LLM responde com confiança. Por isso entender a matemática não é luxo acadêmico. É o que permite olhar para um retrieval ruim e saber em qual elo procurar, em vez de trocar o modelo e torcer.