
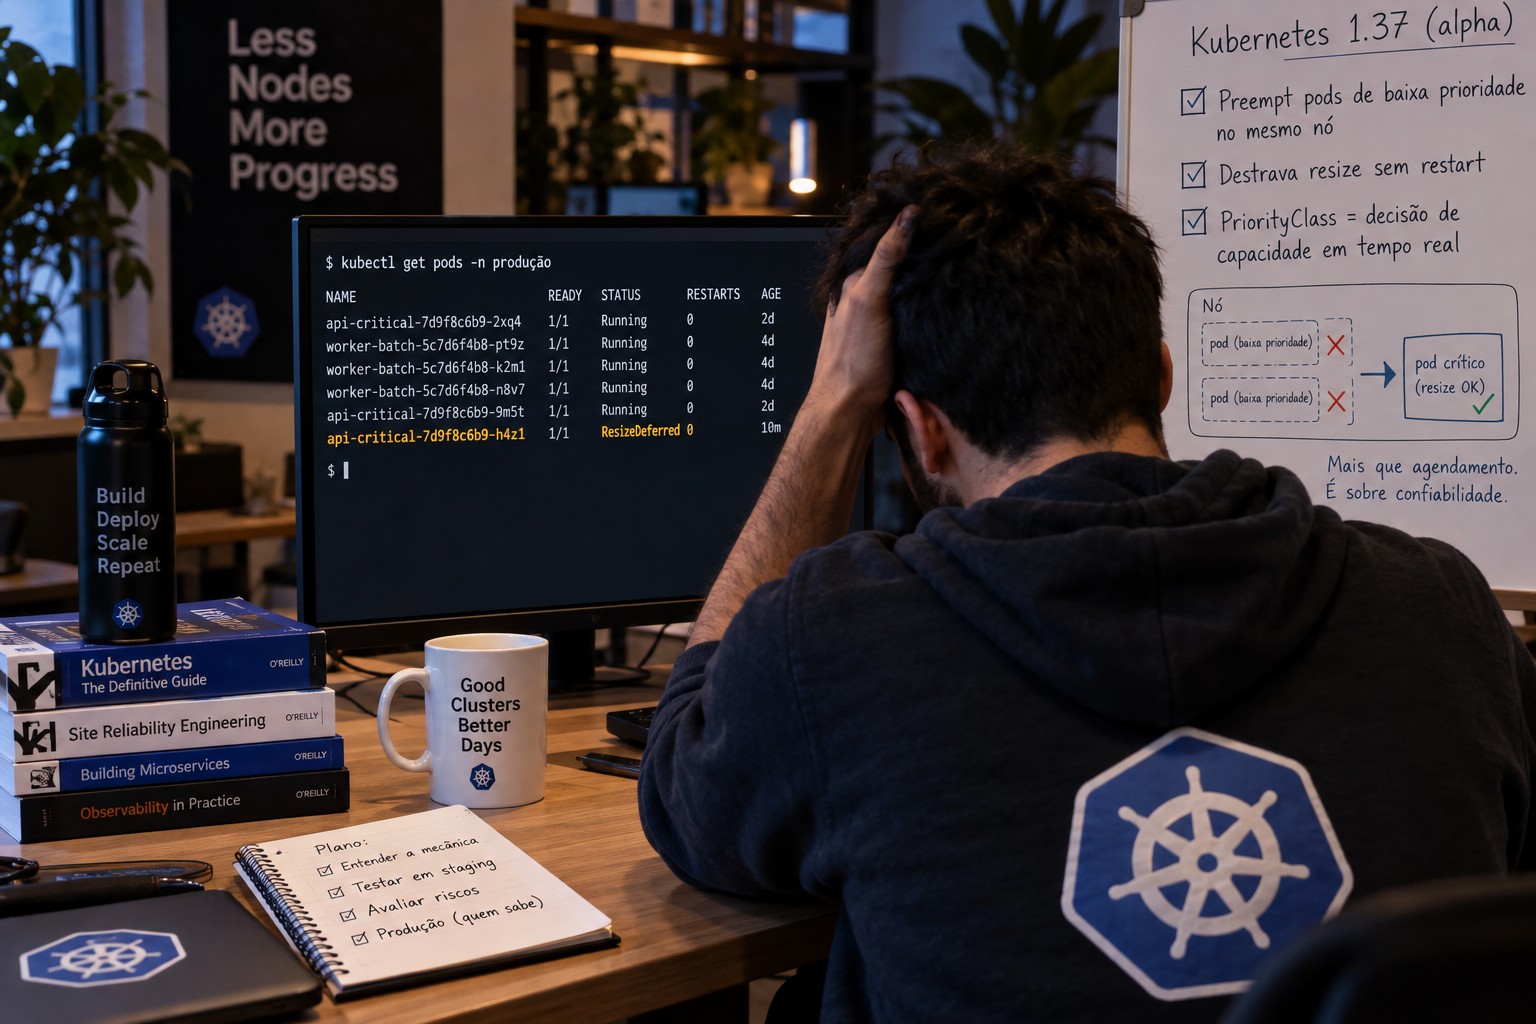
Se você já mexeu com in-place pod resize sabe da frustração: o recurso chegou a GA na 1.35 prometendo ajustar CPU e memória de um container rodando, sem restart — ótimo para banco em memória, servidor web, qualquer coisa que não pode "piscar". Só que ele tinha um buraco feio. Se o nó não tivesse allocatable headroom sobrando na hora do pedido, o Kubelet marcava o resize como Deferred e pronto: o pod ficava ali, esperando o nó liberar espaço por conta própria. Podia ser em cinco minutos. Podia ser nunca.
Eu já vi esse cenário de perto: um VPA sobe o requests de uma aplicação crítica no meio de um pico de tráfego, o nó está lotado por causa do bin-packing de jobs em batch, e o resize simplesmente não acontece. Não dá erro, não falha, só fica pendurado. Na prática, era o Kubernetes te dizendo "eu sei o que você precisa, mas não vou fazer nada a respeito".
O Kubernetes v1.37 muda isso. O recurso scheduler preemption for in-place pod resize, ainda em alpha atrás da feature gate InPlacePodVerticalScalingSchedulerPreemption, dá ao scheduler o poder de despejar pods de prioridade menor no mesmo nó para abrir espaço e destravar o resize. Vamos entender a mecânica, os detalhes que importam na operação e onde isso ainda deixa a desejar.
Deferred não é Infeasible — e essa distinção importa
Antes de ir para o novo comportamento, vale fixar uma distinção que o próprio Kubernetes já fazia e que continua central aqui. Quando um controlador — o VPA é o exemplo mais comum, mas pode ser qualquer client que faça patch no subresource resize — aumenta o requests de um container ativo, o Kubelet avalia dois cenários possíveis:
Infeasible: o pedido é rejeitado na hora porque estoura algo estrutural — os limites físicos do nó, o LimitRange do namespace, a quota de admissão. Não tem negociação aqui; o pedido está errado ou é grande demais para aquele ambiente, ponto final.
Deferred: o pedido é válido, cabe nas regras, só não tem capacidade alocável disponível agora. É uma questão de timing, não de limite.
O problema histórico é que, antes da 1.37, Deferred podia significar "para sempre" na prática. O kube-scheduler já sabe fazer preemption por prioridade — é assim que ele decide qual pod agendar quando o cluster está cheio na hora do agendamento inicial. Mas essa lógica nunca enxergava resizes de pods que já estavam rodando. Um resize deferido ficava fora do radar do scheduler, e as únicas saídas eram manuais: você despejar pods de baixa prioridade na unha, torcer para o cluster autoscaler subir um nó maior (o que na prática reagenda o pod e quebra a própria promessa de "sem restart" do recurso), ou manter um autoscaler customizado só para isso.
Isso empurrava todo mundo para um dilema real de operação: encher os nós com batch e workloads best-effort melhora a utilização e corta custo de cloud, mas rouba exatamente a folga que a carga crítica ia precisar num pico. Ou você mantém buffer ocioso pagando por CPU parada, ou aceita o risco de a aplicação importante não ter para onde crescer. Não dava para ter densidade e confiabilidade ao mesmo tempo — até agora.
Como o scheduler passa a agir
Normalmente, um pod com spec.nodeName preenchido é tratado como já colocado e sai da fila ativa do scheduler — ele não volta a ser avaliado. Com a feature gate ligada, isso muda especificamente para pods com resize Deferred: o scheduler passa a rastreá-los ativamente, com o objetivo único de disparar preemption e acompanhar o resize até o Kubelet concluir.
Alguns pontos de arquitetura mudam o comportamento de um jeito que afeta diretamente como você vai operar isso:
A preemption fica presa ao nó. Isso é o ponto que mais gera expectativa errada. A preemption clássica de agendamento varre o cluster inteiro procurando o melhor lugar para encaixar um pod. Aqui não: o scheduler só considera vítimas no mesmo nó onde o pod deferido já está rodando. Se despejar todos os pods elegíveis daquele nó ainda não abrir espaço suficiente, o resize continua Deferred — mesmo que sobre capacidade de sobra em outro nó do cluster. Não existe migração. Isso significa que a eficácia do recurso depende diretamente de como você distribui prioridades e workloads entre os nós, não só do cluster como um todo.
O recurso é reservado antes de existir. Para evitar corrida — dois resizes disputando a mesma capacidade recém-liberada — o scheduler trata o recurso do pedido como já consumido assim que decide preemptar. Isso garante ao Kubelet que, quando a preemption terminar, a capacidade vai estar lá esperando.
A decisão sai do Kubelet e vai para o scheduler. O Kubelet tem um critical Pod admission handler que historicamente podia despejar pods localmente para garantir espaço para carga crítica na admissão. Com a feature gate ativa, esse handler para de fazer preemption própria para resize: ele apenas defere e delega a decisão inteiramente ao scheduler central. Do ponto de vista de operação, isso é uma boa notícia — você passa a ter um único lugar que decide preemption de resize, respeitando prioridades globais, PDBs e terminação graciosa, em vez de dois mecanismos independentes competindo pela mesma decisão.
Prioridades disputam entre si em tempo real. Se durante uma rodada de preemption chega um pedido de resize com prioridade ainda maior, para outro pod do mesmo nó, o Kubelet prioriza esse novo pedido e o scheduler recalcula, dispara nova rodada de preemption se for preciso liberar mais capacidade.
Tem também uma válvula de escape no nível do nó — e essa eu acho que vale mais atenção do que o post original dá. Um novo campo spec.podPreemptionPolicy permite desligar a preemption de resize nó a nó:
apiVersion: v1
kind: Node
metadata:
name: batch-workload-node
spec:
podPreemptionPolicy:
disableResizePreemption:
- "cluster-autoscaler.kubernetes.io/disable-preemption"
- "operator.example.com/policy-override"
O uso que o próprio SIG Scheduling cita é o de um controlador que prefere resolver a falta de capacidade de outro jeito — reduzindo outros pods por conta própria ou ajustando o tamanho do nó — deixando a preemption do scheduler só como último recurso. Faz sentido pensar nisso como uma faixa de nós "protegidos": se você tem um pool inteiro dedicado a batch e não quer que ele vire moeda de troca toda vez que uma aplicação crítica precisa crescer, esse é o botão que resolve, sem precisar reestruturar prioridades.
Por que isso não dava para resolver com HPA ou cluster autoscaler
Vale parar um segundo para explicar por que essa lacuna incomodava tanto quem já lida com autoscaling — porque a reação natural de quem não viveu isso é pensar "mas o Kubernetes já tem HPA e cluster autoscaler, por que precisava de mais um mecanismo?".
O HPA resolve escala horizontal: sobe réplicas. Isso não ajuda em nada quando o problema é vertical — uma aplicação stateful, um banco em memória, um processo que não pode simplesmente ganhar uma segunda instância porque mantém estado local ou uma conexão persistente cara de recriar. É exatamente o público que o in-place pod resize foi feito para atender, e é exatamente esse público que ficava mais exposto ao Deferred permanente, porque não tinha a saída de "sobe mais um pod" como plano B.
O cluster autoscaler resolve capacidade, mas na escala errada de tempo e com o efeito colateral errado. Ele reage a pods pendentes de agendamento, não a resizes deferidos de pods que já estão rodando — então, na prática, ele só entra em ação se alguém escrever automação própria para forçar isso, geralmente via um pod "âncora" de baixa prioridade que existe só para ser despejado e sinalizar falta de capacidade, ou via webhook customizado observando o resizeStatus. E mesmo quando funciona, subir um nó novo leva minutos — no meio de um pico de tráfego, minutos é tempo que uma aplicação sob pressão de memória não tem.
O VPA, por sua vez, é quem gera o pedido de resize, mas nunca teve visibilidade sobre capacidade de nó — ele decide "quanto" mas não decide "onde tem espaço". Cada peça do ecossistema de autoscaling resolvia uma parte do problema e nenhuma delas fechava o ciclo completo entre "preciso de mais recurso agora" e "esse recurso está disponível agora, no lugar certo". A preemption do scheduler para resize é a primeira peça que efetivamente fecha esse ciclo sem intervenção manual.
O efeito colateral que ninguém comenta: PriorityClass vira decisão de capacidade, não só de agendamento
Esse é o ponto que eu acho mais importante entender antes de sair configurando isso em produção, e que o anúncio oficial não trata com o peso que merece.
Até a 1.36, PriorityClass era, na prática, uma decisão que só importava no momento do agendamento inicial e em cenários de pressão extrema de recursos (node pressure eviction). Configurar prioridades errado tinha um raio de efeito limitado: na pior das hipóteses, um pod de baixa prioridade demorava mais para ser agendado, ou era despejado num cenário já excepcional de falta de memória/disco no nó.
Com a preemption de resize ligada, PriorityClass passa a ser, indiretamente, uma política de capacidade viva — ela decide, em tempo real e de forma automática, qual workload perde CPU e memória toda vez que outro workload no mesmo nó pede para crescer. Isso é uma mudança de categoria, não de grau. Um job de batch marcado com prioridade baixa "só para não atrapalhar o agendamento" pode passar a ser despejado dezenas de vezes por dia, silenciosamente, cada vez que alguma aplicação de prioridade alta no mesmo nó tiver um resize aprovado por VPA. Se esse job não for de fato tolerante a isso — se ele não tiver checkpoint, se reprocessar do zero for caro, se o SLA dele importar mais do que a etiqueta de prioridade sugere — você criou uma fonte nova de instabilidade justamente na parte do cluster que achava mais segura de comprimir.
Na prática, isso empurra uma tarefa de higiene que muita gente nunca fez direito: auditar o que de fato está rodando com prioridade baixa no cluster e confirmar que o rótulo reflete tolerância real a disrupção, não só uma convenção herdada de outro contexto.
Como isso aparece na observabilidade — e o que vale monitorar
Um ponto prático que fica implícito no anúncio: os eventos que aparecem no kubectl get events (ResizeDeferred, Preempted, ResizeStarted, ResizeCompleted) são exatamente o que você quer transformar em sinal de monitoramento antes de confiar nisso em produção, não só olhar manualmente durante um teste pontual.
Alguns pontos que eu colocaria num painel ou alerta desde o primeiro dia com a feature gate ligada:
Contagem de Preempted por nó, ao longo do tempo. Um nó que concentra preempções constantes é sinal de que a distribuição de prioridades ali está desequilibrada, ou que aquele nó virou o "amortecedor" de todo o cluster sem ninguém ter decidido isso conscientemente.
Tempo entre ResizeDeferred e ResizeCompleted. É a métrica mais direta de latência real do mecanismo — quanto tempo uma aplicação crítica fica de fato sem a capacidade que pediu, mesmo com a preemption funcionando. Se esse tempo for alto, a preemption está acontecendo, mas não está sendo rápida o suficiente para o caso de uso.
Resizes que permanecem em Deferred além de um limite de tempo aceitável. Esse é o sintoma direto da limitação de preemption presa ao nó: indica que, mesmo despejando tudo que era elegível, não sobrou capacidade suficiente ali. Vale alertar sobre isso separado de um Deferred comum, porque é o cenário em que a automação nova simplesmente não resolveu o problema.
Quais workloads são despejados com mais frequência, cruzando com se eles têm PDB configurado e qual é a tolerância real deles a restart. Isso fecha o ciclo da auditoria de prioridades que mencionei acima — sem esse dado, a auditoria vira achismo.
Vendo funcionar num kind local
Dá para reproduzir isso num cluster kind de nó único, o que ajuda bastante a internalizar a mecânica antes de discutir isso num contexto real de cluster. A feature gate liga na criação do cluster:
# kind-config.yaml
kind: Cluster
apiVersion: kind.x-k8s.io/v1alpha4
featureGates:
InPlacePodVerticalScalingSchedulerPreemption: true
kind create cluster --config kind-config.yaml --image kindest/node:v1.37.0
Com um nó de 8 CPUs alocáveis, o teste sobe duas PriorityClass (high-priority valendo 1000000, low-priority valendo 1000), um pod de baixa prioridade consumindo 3 CPUs e um de alta consumindo 4 — 7 das 8 CPUs ocupadas, sobrando só 1. Depois vem o gatilho: um patch pede que o pod de alta prioridade suba de 4 para 6 CPUs, um delta de +2 que não cabe na folga de 1 CPU disponível.
kubectl patch pod high-priority-pod --subresource resize --patch \
'{"spec":{"containers":[{"name":"app", "resources":{"requests":{"cpu":"6"}, "limits":{"cpu":"6"}}}]}}'
O histórico de eventos conta a sequência inteira. No pod de baixa prioridade: Preempted seguido de Killing. No de alta: primeiro ResizeDeferred com o erro OutOfcpu: Node didn't have enough resource: cpu, requested: 6000, used: 3950, capacity: 8000, depois ResizeStarted assim que a capacidade é liberada, e por fim ResizeCompleted. A confirmação final:
kubectl get pod high-priority-pod -o jsonpath='{.status.containerStatuses[0].allocatedResources.cpu}{"\n"}'
O container passa de 4 para 6 CPUs ajustando os limites de cgroup via container runtime — sem reiniciar. Esse ResizeCompleted com o contador de RESTARTS intacto é exatamente o que diferencia isso de um reagendamento disfarçado.
O que isso muda na prática de quem opera cluster
A leitura direta é: dá para empurrar o bin-packing mais longe com menos medo. Preencher a folga dos nós com batch e processamento em background deixa de ser uma aposta contra o próximo pico de carga crítica, porque agora existe um mecanismo automático para reabrir espaço quando for preciso. Para quem sente no bolso o custo de manter nós ociosos só como buffer de segurança — e no câmbio que a gente paga em cloud isso não é pouco — a promessa é utilização mais alta sem abrir mão da resposta das aplicações sensíveis.
Só que vale ser direto sobre os limites de maturidade e de desenho:
É alpha. Não é para produção, e isso não é figura de linguagem — é preciso ligar a feature gate em kube-apiserver, kube-scheduler e kubelet, no control plane e em todos os workers, em v1.37 ou superior. Qualquer inconsistência de versão entre esses componentes é terreno fértil para comportamento inesperado.
A preemption presa ao nó é a pegadinha mais provável de morder alguém. Um resize pode continuar Deferred com o cluster inteiro tendo espaço de sobra, só porque a folga está no nó errado. Isso muda a forma como vale pensar em topologia: se você quer que esse mecanismo funcione de verdade, prioridade e distribuição de workload entre nós importam tanto quanto capacidade total do cluster.
PDBs e prioridades mal configurados viram risco automático. Antes, despejar um pod de baixa prioridade era uma decisão manual, feita por alguém olhando o cluster. Agora é uma decisão automática, do scheduler, disparada por qualquer resize de prioridade maior. Se as prioridades não refletem de verdade o que é descartável e o que não é, ou se os PDBs estão frouxos, você está automatizando um jeito novo de derrubar coisa que não devia.
A régua que eu aplicaria aqui é a mesma de qualquer feature alpha que mexe com disrupção automática: se não dá para medir o efeito da preemption e reverter o comportamento — o spec.podPreemptionPolicy existe exatamente para isso — não é hora de colocar no cluster que importa.
Um roteiro razoável para quem quiser testar isso antes de qualquer plano de produção:
Ligar a feature gate só num cluster de teste, com topologia de nós parecida com a de produção — se a preemption é presa ao nó, testar num cluster de nó único (como o exemplo do kind) mostra a mecânica, mas não mostra o efeito real de distribuição de workload entre nós.
Auditar as PriorityClass existentes antes de qualquer coisa, perguntando literalmente "esse workload tolera ser despejado sem aviso, várias vezes por dia?" para cada um marcado como baixa prioridade.
Instrumentar os eventos de resize e preemption como métrica antes de ligar em qualquer lugar que importe — não depois.
Definir de antemão quais nós entram na lista de exceção via spec.podPreemptionPolicy, em vez de descobrir na marra que um pool de batch importante virou moeda de troca.
Rodar em paralelo com o comportamento antigo por um tempo, comparando quantos resizes que antes ficariam Deferred para sempre agora resolvem via preemption — esse número é o que justifica (ou não) assumir o risco de uma feature alpha.
Ligar em ambiente de teste, observar os eventos, ajustar prioridades e PDBs antes de cogitar produção é o caminho que faz sentido, e é também o que o próprio SIG Scheduling está pedindo enquanto o recurso amadurece.
Fonte: Kubernetes Blog — Kubernetes v1.37: Scheduler Preemption for In-Place Pod Resize (Alpha)