
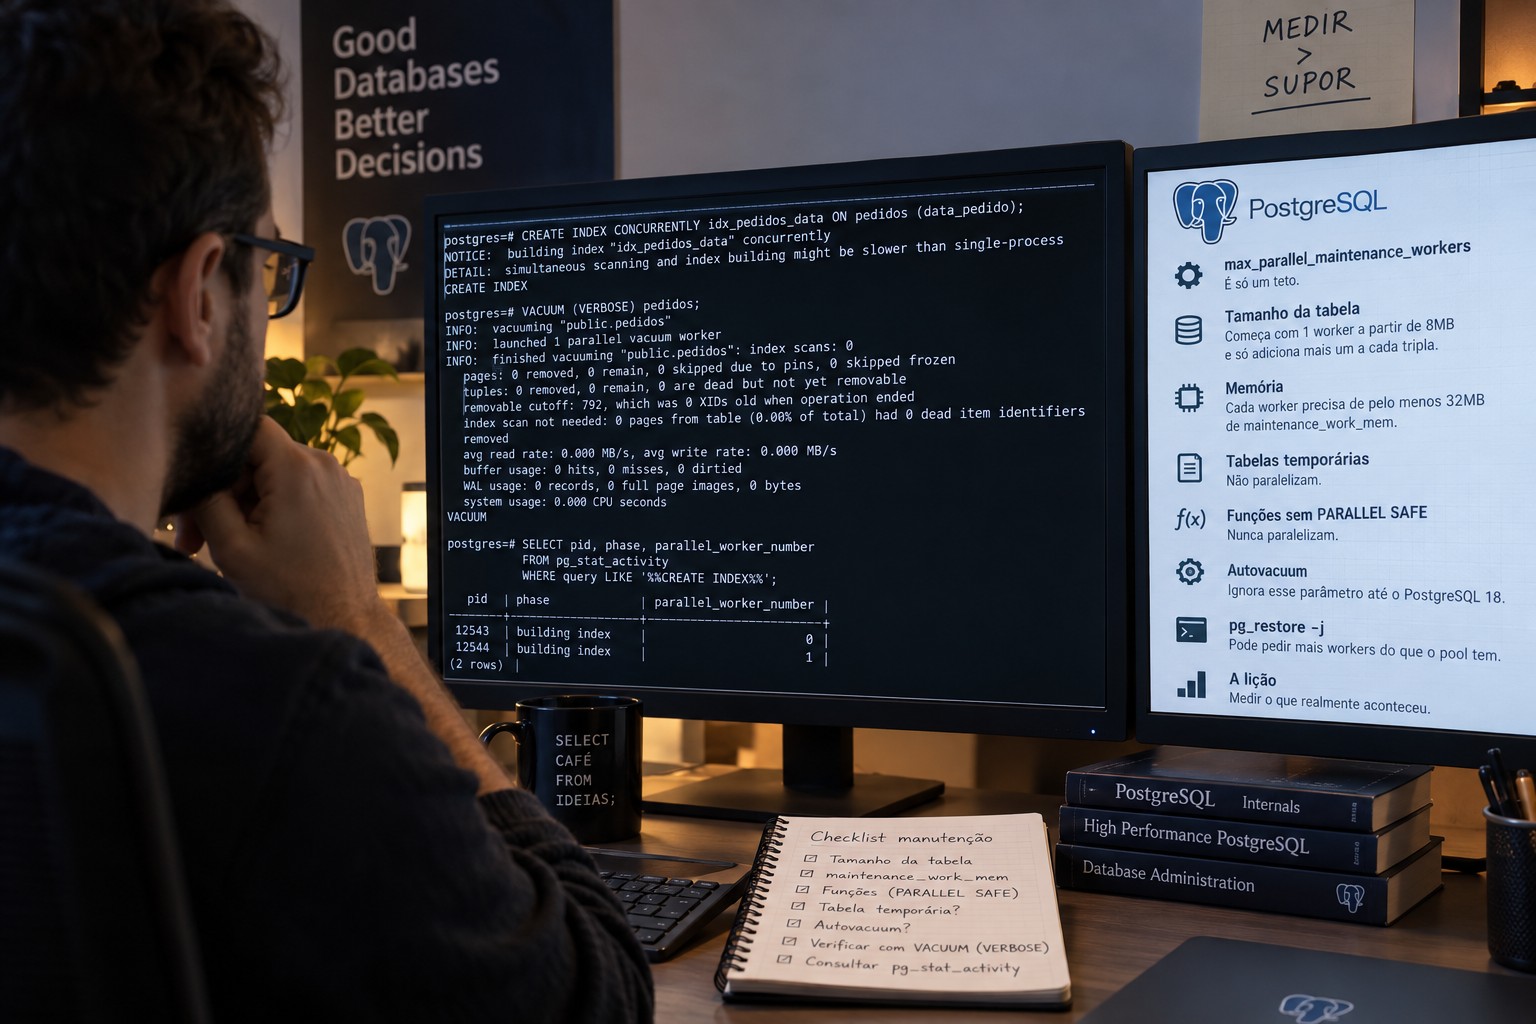
Christophe Pettus destrincha o parâmetro que controla o paralelismo em CREATE INDEX e VACUUM e mostra por que aumentar o valor raramente faz o Postgres usar mais workers.
Poucos parâmetros do PostgreSQL geram tanta confusão silenciosa quanto max_parallel_maintenance_workers. Ele parece simples: define quantos processos paralelos uma operação de manutenção pode usar. Na prática, é um teto que raramente é alcançado, porque outras regras entram na frente dele e ninguém é avisado quando isso acontece.
Esse é o argumento central do post All Your GUCs in a Row: max_parallel_maintenance_workers, de Christophe Pettus, mais um capítulo de uma série que já passou por maintenance_work_mem, max_logical_replication_workers e max_files_per_process. O resultado é um mapa de tudo o que precisa dar certo entre o valor que você configurou e o número de processos que realmente trabalham.
O parâmetro em resumo
- Contexto
user: pode ser alterado por sessão, sem reiniciar nada - Aceita valores de 0 a 1024, e
0desliga o paralelismo de manutenção - Default:
2 - Chegou no PostgreSQL 11, junto com a construção paralela de índices B-tree
A cobertura foi crescendo com as versões: o vacuum paralelo de índices veio no 13, o suporte a BRIN no 17 e o a GIN no 18. Hash, GiST e SP-GiST continuam construindo de forma serial até o 18, e também na beta 3 do 19, que Pettus usou nos testes.
Um teto por comando, não um pool
O erro mais comum, que o próprio Pettus admite ter cometido em um post de 2023, é tratar o parâmetro como um limite global de workers de manutenção no cluster. Ele é um limite por comando. Nos testes, três CREATE INDEX simultâneos com o parâmetro em 2 resultaram em seis workers vivos, dois sob cada processo líder.
O teto real para o total de workers ativos vem de outros dois parâmetros: max_parallel_workers e max_worker_processes. Isso muda a conta de quem administra um banco grande com várias cargas de manutenção concorrentes. Vários REINDEX em paralelo em tabelas diferentes, ou um pg_restore -j, podem esgotar o pool mesmo com cada comando individual "dentro do limite".
As três etapas antes de chegar no seu número
A parte mais densa do post explica o cálculo que uma construção de índice faz antes de considerar o que você configurou.
1. A escada de tamanho da tabela. É a mesma usada pelo planner para scans paralelos: 1 worker a partir de 8MB de heap, e mais um cada vez que o tamanho triplica. É uma escada lenta. Uma tabela de 782MB pediu 5 workers com o parâmetro em 8 e continuou pedindo 5 com ele em 1024. Aplicando a regra do triplo, o desenho fica assim:
| Tamanho da tabela (heap) | Workers pedidos |
|---|---|
| a partir de 8MB | 1 |
| a partir de ~24MB | 2 |
| a partir de ~72MB | 3 |
| a partir de ~216MB | 4 |
| a partir de ~650MB | 5 |
| a partir de ~1,9GB | 6 |
| a partir de ~5,7GB | 7 |
| a partir de ~17GB | 8 |
| a partir de ~1,35TB | 12 |
| a partir de ~4TB | 13 |
Na prática, até uma tabela passar de 4TB, configurar o parâmetro em 64 não faz diferença nenhuma em relação a configurá-lo em 12.
2. O teto do próprio parâmetro, que corta o que a escada pediu.
3. O piso de memória. Cada participante, incluindo o líder, precisa ficar com pelo menos 32MB de maintenance_work_mem. A fórmula é 32MB × (N + 1) para N workers: 160MB para quatro, 224MB para seis, 288MB para oito.
No default de 64MB, uma construção de índice tem direito a exatamente um worker, não importa quão alto esteja o parâmetro. Ou seja: numa instalação padrão, sem tocar em maintenance_work_mem, o índice nunca chega nem ao próprio default de 2 do GUC.
O resultado das três etapas é apenas um pedido. Se os workers existirem de fato, isso depende do pool no momento, e a falha nessa entrega é silenciosa: o comando roda com o que conseguiu, sem erro nem aviso.
O atalho: parallel_workers por tabela
O parâmetro de armazenamento parallel_workers pula a escada e o piso de memória, mas não o teto do GUC. No teste de Pettus, com parallel_workers = 6, o parâmetro global em 8 e 64MB de memória, a construção pediu os seis workers e deixou cerca de 9MB para cada um ordenar dados, o que é pouco.
Como esse parâmetro também influencia planos de query paralelos contra a tabela, o conselho é setá-lo só para a construção e resetá-lo em seguida:
ALTER TABLE minha_tabela SET (parallel_workers = 6);
CREATE INDEX CONCURRENTLY idx_exemplo ON minha_tabela (coluna);
ALTER TABLE minha_tabela RESET (parallel_workers);
O que nunca paraleliza
Algumas construções nem chegam a pedir workers:
- Tabelas temporárias sempre constroem de forma serial.
- Índices cuja expressão ou predicado chama função não marcada
PARALLEL SAFE. ComoCREATE FUNCTIONassumePARALLEL UNSAFEpor padrão, isso cobre a maioria das funçõesIMMUTABLEcaseiras que times criam sem revisar esse detalhe. Funções SQL simples que o planner faz inline escapam da checagem, e é por isso que o comportamento parece aleatório até se conhecer a regra.
O mesmo caminho de decisão vale para mais do que CREATE INDEX. Na versão 18.6 testada, REINDEX (no CONCURRENTLY, só o primeiro scan da tabela é paralelo), ALTER TABLE ... ADD PRIMARY KEY, ADD UNIQUE e as reconstruções de índice ao final de CLUSTER e VACUUM FULL também pediram workers normalmente.
VACUUM segue outra lógica
O VACUUM usa o parâmetro de outro jeito:
- Só as fases de índice rodam em paralelo
- A unidade de trabalho é um índice inteiro, não uma fração dele
- O processo líder já toma um índice para si
O número de workers é a quantidade de índices com pelo menos min_parallel_index_scan_size (512kB), menos um, limitada pela opção PARALLEL se ela foi passada, e limitada de novo pelo GUC. Numa tabela com quatro índices, VACUUM (PARALLEL 8) no default lança dois workers.
Aqui não existe a regra dos 32MB, então um VACUUM manual nessa mesma tabela já lança dois workers numa instalação padrão, sem que ninguém peça. Em compensação, uma tabela com um único índice enorme não recebe worker nenhum, seja qual for a configuração, e o scan da heap nunca é paralelo.
E o autovacuum?
O ponto que mais muda o planejamento: o autovacuum ignora esse parâmetro até o PostgreSQL 18. Ele nunca usa workers paralelos, então max_parallel_maintenance_workers só afeta o VACUUM digitado manualmente ou disparado por vacuumdb.
O PostgreSQL 19 introduz um parâmetro separado, autovacuum_max_parallel_workers (contexto sighup, default 0), que não interage com o antigo. Na beta 3, com o parâmetro clássico em 0 e o novo em 2, o autovacuum planejou e lançou dois workers enquanto um VACUUM (PARALLEL 4) manual, rodando ao mesmo tempo, ficou totalmente serial.
Ajustando na prática
Os números que Pettus já recomendava em 2023 continuam valendo: 2 para máquinas pequenas, 4 acima de oito núcleos e 6 para hardware bem maior. Só fazem sentido se houver memória para alcançá-los, e uma faixa global de 256MB a 1GB de maintenance_work_mem cobre o piso para qualquer um desses valores.
Como o contexto é user, para uma construção grande e pontual o melhor caminho é ajustar os dois parâmetros na própria sessão, sem tocar nos globais do cluster:
SET maintenance_work_mem = '1GB';
SET max_parallel_maintenance_workers = 4;
CREATE INDEX CONCURRENTLY idx_exemplo ON minha_tabela (coluna);
O caso do pg_restore -j
É onde isso costuma dar errado. Cada job é uma sessão rodando o próprio comando, então quatro jobs com o parâmetro em 4 podem pedir dezesseis workers de um pool que, na configuração padrão, tem sete para oferecer. No teste do post, quatro jobs pediram três workers cada e o máximo vivo ao mesmo tempo foi sete, divididos em três, três e um.
A solução é limitar só as sessões da restauração:
PGOPTIONS='-c max_parallel_maintenance_workers=2 -c maintenance_work_mem=1GB' pg_restore -j 4 ...
A regra de bolso: jobs × (workers + 1) deve ficar próximo do número de núcleos, e max_parallel_workers precisa cobrir jobs × workers. Se isso exigir subir também max_worker_processes, essa mudança exige reinício do servidor.
Como conferir se funcionou
O VACUUM (VERBOSE) informa direto: launched 2 parallel vacuum workers for index vacuuming (planned: 2).
Construções de índice são mais discretas. SET client_min_messages = debug1 mostra uma linha dizendo que o índice está sendo construído with request for N parallel workers ou serially, mas isso é o pedido, não a entrega. Para saber o que de fato foi lançado, é preciso contar os workers vivos enquanto a construção roda:
SELECT leader_pid, count(*) AS workers
FROM pg_stat_activity
WHERE backend_type = 'parallel worker'
GROUP BY leader_pid;
O que isso muda para quem administra
Pettus resume o problema numa frase:
Subir o valor é fácil. Difícil é fazer o comando usar o que você liberou.
Christophe Pettus
A lição prática é parar de tratar o valor do GUC como indicador de paralelismo real. Quando um índice ou um vacuum não acelera depois de você aumentar o parâmetro, o diagnóstico segue sempre a mesma ordem:
- A tabela é grande o bastante para a escada pedir mais de um worker?
- O
maintenance_work_memcobre32MB × (N + 1)? - Alguma função do índice está sem
PARALLEL SAFE, ou a tabela é temporária? - O pool (
max_parallel_workersemax_worker_processes) tem folga naquele momento? - Se é autovacuum, a versão é anterior ao 19?
Antes de comprar mais CPU ou reescrever a janela de manutenção, vale conferir se o comando simplesmente nunca pediu o que você achou que tinha liberado. E confirmar em VACUUM (VERBOSE) ou pg_stat_activity, não no postgresql.conf.
Fonte: Planet PostgreSQL